ไฟล์ ข้อมูล และไลบรารี
UAT 104 การเขียนโปรแกรมคอมพิวเตอร์
บทเรียน
เมื่อเรียนจบโมดูลนี้ ผู้เรียนจะสามารถ
- อ่านและเขียนไฟล์ CSV และ JSON โดยกำหนดการเข้ารหัสอักขระ UTF-8 ให้ถูกต้อง
- ใช้ pandas อ่าน สำรวจ และสรุปข้อมูล flight log
- ตรวจหาค่าหายและค่าผิดปกติ แล้วแก้ไขด้วย .loc ตามกติกา Copy-on-Write ของ pandas 3
- สรุปข้อมูลตามกลุ่มด้วย groupby และวาดกราฟด้วย matplotlib
- อธิบายว่าวิธีประมวลผลข้อมูลส่งผลต่อคำตอบอย่างไร
ทำไมต้องรู้
ข้อมูลจากโดรนจริงไม่เคยสะอาด เซนเซอร์กระตุกเป็นครั้งคราว สัญญาณ GPS อ่อนเมื่อใกล้อาคาร และบางแถวก็ไม่มีค่า ถ้านำข้อมูลดิบไปสรุปทันที จะได้ความสูงสูงสุด ระยะบิน หรือการใช้พลังงานที่ผิด และอาจนำไปสู่การตัดสินใจที่ผิด ทักษะสำคัญของนักเทคโนโลยีจึงไม่ใช่แค่คำนวณเป็น แต่คือ ตรวจข้อมูลก่อนเชื่อ
โมดูลนี้ใช้ไฟล์ flight_log_sample.csv ซึ่งเป็น ข้อมูลสังเคราะห์ จากแบบจำลองเที่ยวบินสำรวจ 403 วินาที บันทึก 2 ครั้งต่อวินาที และตั้งใจใส่ปัญหาไว้ให้ฝึกหา สร้างซ้ำได้ด้วย make_sample_data.py
อ่านและเขียนไฟล์
CSV และปัญหาภาษาไทย
ถ้าไม่ระบุการเข้ารหัสอักขระ Python รุ่นก่อน 3.15 จะใช้ค่าตามภาษาของเครื่อง ซึ่งบน Windows ภาษาไทยอาจเป็น code page 874 ไฟล์ที่เขียนบนเครื่องหนึ่งจึงอาจอ่านเป็นตัวอักษรเพี้ยนบนอีกเครื่อง PEP 686 จะเปลี่ยนค่าเริ่มต้นเป็น UTF-8 ตั้งแต่ Python 3.15 แต่ระหว่างนี้ ให้ระบุ encoding="utf-8" ทุกครั้ง และเปิดไฟล์ CSV ด้วย newline="" ตามเอกสารของโมดูล csv
import csv

with open("flight_log_sample.csv", encoding="utf-8", newline="") as f:
    rows = list(csv.DictReader(f))

print(len(rows), "rows")
print(rows[0]["t_s"], rows[0]["alt_m"], rows[0]["mode"])
print(type(rows[0]["alt_m"]))
807 rows
0.0 -0.06 GUIDED
<class 'str'>สังเกตว่าโมดูล csv คืนทุกค่าเป็นข้อความ (str) ต้องแปลงเป็นตัวเลขเอง ซึ่งเป็นเหตุผลหนึ่งที่งานวิเคราะห์นิยมใช้ pandas
JSON สำหรับผลสรุป
JSON เหมาะกับการเก็บผลสรุปหรือการตั้งค่าที่มีโครงสร้าง ใช้ ensure_ascii=False เพื่อให้ภาษาไทยในไฟล์อ่านได้ ไม่ถูกแปลงเป็นรหัส ส...
import json
from pathlib import Path

summary = {"flight": "สำรวจแปลง A", "rows": len(rows)}
path = Path("summary.json")
path.write_text(json.dumps(summary, ensure_ascii=False, indent=2), encoding="utf-8")

print(path.read_text(encoding="utf-8"))
print(json.loads(path.read_text(encoding="utf-8"))["flight"])
{
"flight": "สำรวจแปลง A",
"rows": 807
}
สำรวจแปลง Aสำรวจข้อมูลด้วย pandas
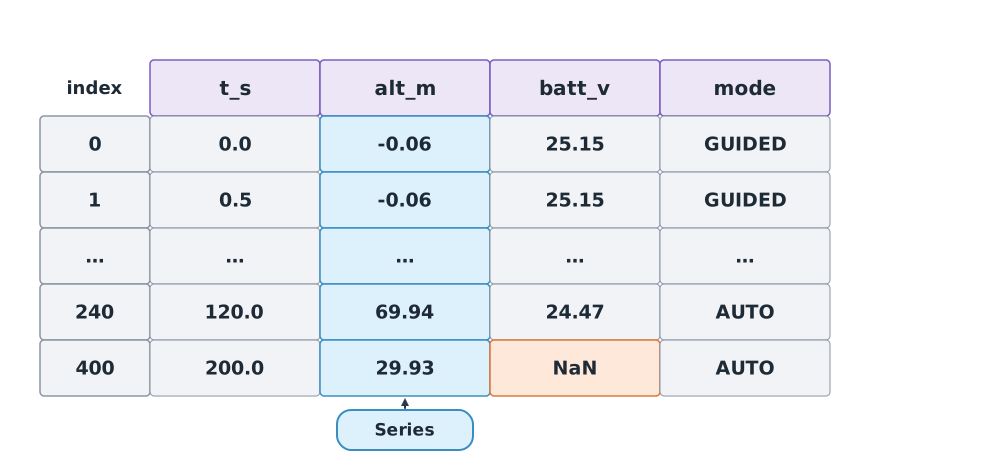
pandas เก็บข้อมูลตารางในรูป DataFrame แต่ละคอลัมน์เป็น Series และแต่ละแถวมี index กำกับ วิชานี้ใช้ pandas 3 ซึ่งต้องใช้ Python 3.11 ขึ้นไป
import pandas as pd

df = pd.read_csv("flight_log_sample.csv")
print(df.shape)
print(df[["t_s", "alt_m", "batt_v", "gps_sats", "mode"]].head(3))
print(df.isna().sum()[lambda s: s > 0])
(807, 10)
t_s alt_m batt_v gps_sats mode
0 0.0 -0.06 25.15 14 GUIDED
1 0.5 -0.06 25.15 14 GUIDED
2 1.0 -0.16 25.18 14 GUIDED
batt_v 2
dtype: int64แถวแรก ๆ ยืนยันว่าอ่านไฟล์ถูก และ isna() บอกว่ามีแรงดันแบตเตอรี่หายไป 2 แถว ขั้นต่อไปคือดูภาพรวมของตัวเลข
print(df[["alt_m", "groundspeed_ms", "batt_v"]].describe().round(2)) alt_m groundspeed_ms batt_v
count 807.00 807.00 805.00
mean 28.15 7.47 24.28
std 6.76 2.77 0.27
min -0.24 0.00 23.85
25% 29.86 7.35 24.05
50% 29.97 8.85 24.27
75% 30.09 9.01 24.48
max 69.94 9.55 25.20ค่า max ของความสูงคือ 69.94 m ทั้งที่แผนบินที่ 30 m และค่ากลาง (50%) อยู่ราว 30 m นี่คือสัญญาณของค่าผิดปกติที่ต้องตรวจก่อนรายงาน
ทำความสะอาดข้อมูล
ตัวอย่างที่ 1 หาและแก้ค่าความสูงที่กระโดด
ใช้ ค่ามัธยฐานเคลื่อนที่ 5 จุด เป็นค่าอ้างอิงของแต่ละจุด ค่าที่ห่างจากค่าอ้างอิงเกิน 5 m ถือว่าผิดปกติ มัธยฐานเหมาะกว่าค่าเฉลี่ย เพราะค่าผิดปกติค่าเดียวไม่ดึงมัธยฐานไปด้วย
df["alt_ref"] = df["alt_m"].rolling(5, center=True, min_periods=1).median()
spike = (df["alt_m"] - df["alt_ref"]).abs() > 5
print(df.loc[spike, ["t_s", "alt_m", "alt_ref"]])

df.loc[spike, "alt_m"] = df.loc[spike, "alt_ref"]
print("max altitude after cleaning:", df["alt_m"].max())
t_s alt_m alt_ref
240 120.0 69.94 30.08
max altitude after cleaning: 30.45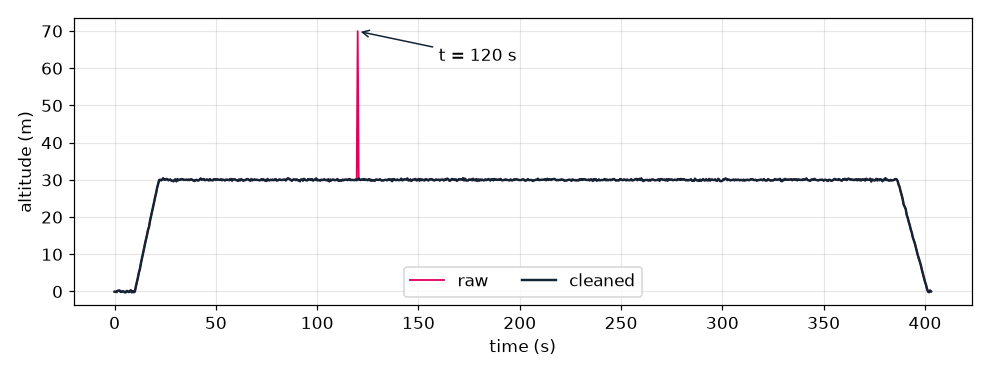
pandas 3: แก้ค่าด้วย .loc เท่านั้น
pandas 3 เปิดใช้ Copy-on-Write เป็นค่าเริ่มต้น การเขียนแบบต่อสาย เช่น df[spike]["alt_m"] = 0 จะไม่เปลี่ยนข้อมูลใน df อีกต่อไป (pandas จะเตือน) ให้เขียน df.loc[เงื่อนไข, "คอลัมน์"] = ค่า ในคำสั่งเดียวเสมอ ตำราหลายเล่มรวมถึงฉบับที่ 3 ของ McKinney เขียนก่อน pandas 3 จึงอาจยังใช้แบบเก่า
ค่าหาย ไม่ควรเติมด้วยการเดา ถ้าจำเป็นต้องเติม ต้องบอกวิธีที่ใช้ เช่น ประมาณค่าระหว่างจุดข้างเคียงด้วย interpolate() และบันทึกว่าเติมกี่แถว
สรุปตามกลุ่ม
groupby แยกข้อมูลตามค่าของคอลัมน์หนึ่ง แล้วสรุปแต่ละกลุ่ม ข้อมูลบันทึกทุก 0.5 s จำนวนแถวคูณ 0.5 จึงเป็นเวลาที่อยู่ในแต่ละโหมด
per_mode = df.groupby("mode").agg(
    samples=("t_s", "size"),
    mean_speed_ms=("groundspeed_ms", "mean"),
)
per_mode["minutes"] = per_mode["samples"] * 0.5 / 60
print(per_mode.round(2).sort_values("minutes", ascending=False))
samples mean_speed_ms minutes
mode
AUTO 659 8.24 5.49
RTL 70 8.50 0.58
GUIDED 44 0.00 0.37
LAND 34 0.00 0.28วิธีคิดเปลี่ยนคำตอบ
ตัวอย่างที่ 2 เที่ยวบินนี้บินไกลเท่าไร
รวมระยะระหว่างจุด GPS ที่ติดกันด้วยสูตร haversine (โมดูล 2) แต่เขียนแบบเวกเตอร์ด้วย NumPy ให้คำนวณทั้งคอลัมน์พร้อมกัน แล้วเทียบหลายวิธี ในฟังก์ชันต้องแปลงค่าเป็น NumPy array ด้วย np.asarray() ก่อน เพราะถ้าตัดช่วงบน pandas Series ตรง ๆ pandas จะจับคู่ข้อมูลตาม index ทำให้คำนวณผิดหรือเกิดข้อผิดพลาด (บั๊กนี้เกิดขึ้นจริงระหว่างเขียนบทเรียนนี้)
import numpy as np


def path_length_m(lat_deg, lon_deg, radius=6_371_000.0):
    """Sum of haversine distances between consecutive points."""
    lat = np.radians(np.asarray(lat_deg, dtype=float))
    lon = np.radians(np.asarray(lon_deg, dtype=float))
    a = np.sin(np.diff(lat) / 2) ** 2 + np.cos(lat[:-1]) * np.cos(lat[1:]) * np.sin(np.diff(lon) / 2) ** 2
    return float((2 * radius * np.arcsin(np.sqrt(a))).sum())


print(f"raw fixes:       {path_length_m(df['lat_deg'], df['lon_deg']):.0f} m")

weak = df["gps_sats"] < 10
fixed = df[["lat_deg", "lon_deg"]].copy()
fixed.loc[weak, ["lat_deg", "lon_deg"]] = np.nan
fixed = fixed.interpolate()
print(f"weak GPS filled: {path_length_m(fixed['lat_deg'], fixed['lon_deg']):.0f} m  ({weak.sum()} fixes)")

for window in (3, 5, 9):
    smooth = fixed.rolling(window, center=True, min_periods=1).mean()
    print(f"smoothed ({window}):    {path_length_m(smooth['lat_deg'], smooth['lon_deg']):.0f} m")
raw fixes: 3092 m
weak GPS filled: 3067 m (10 fixes)
smoothed (3): 3014 m
smoothed (5): 2991 m
smoothed (9): 2951 mเส้นทางตามแผนของแบบจำลองยาว 3 015 m ข้อมูลดิบให้ ยาวเกินจริง เพราะสัญญาณรบกวนทำให้ตำแหน่งแกว่งไปมา และช่วง GPS อ่อน 10 จุดทำให้แกว่งมากที่สุด การปรับให้เรียบช่วยได้ แต่ถ้าหน้าต่างกว้างเกินไปจะ ตัดมุม ที่จุดเลี้ยว ได้ระยะสั้นเกินจริง
ไม่มีวิธีใดถูกเสมอ หลักคือ รายงานวิธีคู่กับผลทุกครั้ง และตรวจกับค่าที่รู้ ในงานจริงอาจไม่มีเส้นทางจริงให้เทียบ แต่ยังเทียบกับแผนบินหรือกับระยะจากเซนเซอร์อื่นได้
วาดกราฟ
matplotlib เป็นไลบรารีกราฟพื้นฐานของ Python บันทึกกราฟเป็นไฟล์ด้วย savefig() เพื่อใส่ในรายงาน ภาพที่ 3 สร้างจากโค้ดแบบเดียวกันนี้
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(9, 3.4))
ax.plot(df["t_s"], df["alt_m"], label="cleaned")
ax.set_xlabel("time (s)")
ax.set_ylabel("altitude (m)")
ax.grid(alpha=0.3)
ax.legend()
fig.tight_layout()
fig.savefig("altitude.png", dpi=110)
print("saved altitude.png")
saved altitude.pngปฏิบัติการประจำโมดูล
ปฏิบัติการ: รายงานคุณภาพข้อมูลเที่ยวบิน
ใช้ไฟล์ flight_log_sample.csv ทำใน Jupyter Notebook
- อ่านไฟล์ ตรวจค่าหาย ค่าผิดปกติของความสูง และช่วงที่ดาวเทียม GPS น้อยกว่า 10 ดวง แล้วรายงานเป็นตาราง
- ทำความสะอาดด้วย
.locและเปรียบเทียบdescribe()ก่อนและหลัง - สรุปเวลาและความเร็วเฉลี่ยของแต่ละโหมดการบิน และหาเวลาที่แบตเตอรี่ลดถึง 90% ครั้งแรก
- คำนวณระยะบินอย่างน้อยสองวิธี อธิบายว่าเลือกวิธีใดเพราะอะไร
- วาดกราฟความสูงและแรงดันแบตเตอรี่เทียบเวลา แล้วส่ง notebook ที่ รันใหม่ตั้งแต่ต้นได้ผลเดิม
ข้อผิดพลาดที่พบบ่อย
ระวัง
- ไม่ระบุ
encoding="utf-8"จนภาษาไทยเพี้ยนบนเครื่องอื่น - รายงานค่า max หรือ min จากข้อมูลดิบ โดยไม่ตรวจค่าผิดปกติ
- แก้ค่าแบบต่อสาย ซึ่งไม่ได้ผลใน pandas 3
- ลบแถวที่มีปัญหาทิ้งเงียบ ๆ โดยไม่บันทึกว่าลบกี่แถวเพราะอะไร
- ปรับข้อมูลให้เรียบมากเกินไป จนเสียรายละเอียดจริง
- แก้ไฟล์ข้อมูลต้นฉบับ แทนที่จะเก็บต้นฉบับไว้และบันทึกผลเป็นไฟล์ใหม่
สรุป
- ระบุ
encoding="utf-8"ทุกครั้งที่อ่านเขียนไฟล์ข้อความ และใช้ensure_ascii=Falseกับ JSON ที่มีภาษาไทย - pandas ใช้
read_csv,head,isna,describe,groupbyสำรวจและสรุปข้อมูล - ค่ามัธยฐานเคลื่อนที่ช่วยหาค่าผิดปกติ และใน pandas 3 ต้องแก้ค่าด้วย
.loc - วิธีประมวลผลเปลี่ยนคำตอบ ต้องรายงานวิธีคู่กับผล
- บันทึกกราฟด้วย
savefig()และทำ notebook ให้รันซ้ำได้ผลเดิม
แบบฝึกตรวจความเข้าใจ
- ทำไมต้องระบุ
encoding="utf-8"เมื่อเปิดไฟล์ใน Python 3.14 บน Windows ภาษาไทย - โมดูล csv คืนค่าในคอลัมน์
alt_mเป็นชนิดใด - ทำไมใช้มัธยฐานเคลื่อนที่แทนค่าเฉลี่ยเคลื่อนที่เพื่อหาค่ากระโดด
- เขียนคำสั่ง pandas 3 ที่ตั้งค่า
batt_vเป็น 0 เฉพาะแถวที่modeเป็น"LAND" - ข้อมูลบันทึกทุก 0.5 s มีแถวในโหมด RTL 70 แถว อยู่ในโหมดนี้กี่วินาที
เฉลย
- ก่อน Python 3.15 ค่าเริ่มต้นขึ้นกับภาษาของเครื่อง ซึ่งอาจเป็น code page 874 ไม่ใช่ UTF-8 ไฟล์จึงอาจอ่านเพี้ยน
str(ข้อความ) ต้องแปลงเป็นตัวเลขเอง- เพราะค่าผิดปกติค่าเดียวดึงค่าเฉลี่ยให้เพี้ยนไปด้วย แต่แทบไม่ทำให้มัธยฐานเปลี่ยน
df.loc[df["mode"] == "LAND", "batt_v"] = 0- s
สรุปสูตรสำคัญ
| ค่ามัธยฐานเคลื่อนที่ (หน้าต่าง 5 จุด) | |
| ระยะทางรวมจากจุด GPS |
แหล่งอ้างอิงหลัก
- Python Software Foundation. The Python tutorial (Python 3.14 documentation). link
- Inada, N. (2022). PEP 686 – Make UTF-8 mode default. link
- The pandas development team. (2026). What’s new in 3.0.0. pandas documentation. link
- The Matplotlib development team. Matplotlib documentation (3.11). link
- McKinney, W. (2022). Python for data analysis (3rd ed.). O'Reilly. link
- Downey, A. B. (2024). Think Python: How to think like a computer scientist (3rd ed.). O’Reilly. link
อ่านเพิ่มเติม
ศึกษาหน่วยความรู้ที่กำหนดล่วงหน้า ดูสื่อประกอบ และทำ quiz ประจำโมดูล
การเขียนโปรแกรม Python สำหรับงานเทคโนโลยี
การจัดการและแสดงผลข้อมูลด้วย Python
ในชั้นเรียน / ภาคสนาม
ปฏิบัติการในห้องแล็บหรือภาคสนามตามใบงาน พร้อม checklist ความปลอดภัย
หลักฐานการเรียนรู้: ใบงานที่ผ่านการตรวจและผล quiz