ชุดข้อมูลและ labeling
UAT 306 ปัญญาประดิษฐ์สำหรับระบบอากาศยานไร้คนขับ
บทเรียน
เมื่อเรียนจบโมดูลนี้ ผู้เรียนจะสามารถ
- เขียนคู่มือการติด label ที่ทำให้ผู้ติด label ต่างคนได้ผลตรงกัน
- วัดความสอดคล้องของผู้ติด label ด้วย Cohen's kappa และ IoU ของกรอบ
- แบ่งชุดข้อมูลตามเที่ยวบินโดยรักษาสัดส่วนคลาสให้ใกล้เคียงกัน
- ตรวจชุดข้อมูลก่อนฝึกเพื่อหาข้อมูลรั่วและ label ผิด
ทำไมต้องรู้
หน่วยความรู้เรื่องเตรียมและแบ่งชุดข้อมูลของคลังความรู้โดรนย้ำว่า โมเดลเรียนได้เท่าที่ข้อมูลและ label สนับสนุน ต้องกำหนดวัตถุที่จะตรวจ ขอบเขตภาพ และสิทธิ์ก่อนรวบรวม และแยกข้อมูลตามกลุ่มที่อาจคล้ายกัน เช่น เที่ยวบินหรือสถานที่ UAT 315 แสดงแล้วว่าการแบ่งแบบสุ่มให้คะแนนดีเกินจริง โมดูลนี้ลงลึกสองเรื่อง คือ label น่าเชื่อถือแค่ไหน และ แบ่งตามเที่ยวบินอย่างไรให้สัดส่วนคลาสใกล้กัน
คู่มือการติด label
ถ้าผู้ติด label สองคนเห็นภาพเดียวกันแล้วติดต่างกัน โมเดลจะเรียนความสับสนนั้นไปด้วย คู่มือที่ดีกำหนด: นิยามของแต่ละคลาสพร้อมภาพตัวอย่างที่ใช่และไม่ใช่ ขนาดเล็กที่สุดที่ต้องติด วิธีวาดกรอบ (ชิดขอบวัตถุ รวมหรือไม่รวมเงา) และสิ่งที่ต้องทำเมื่อไม่แน่ใจ หน่วยความรู้เรื่อง CVAT ของคลังความรู้โดรนสาธิตการติด label ตรวจ และส่งออกในรูปแบบสำหรับฝึก
ตัวอย่างที่ 1 ผู้ติด label สองคนตรงกันแค่ไหน
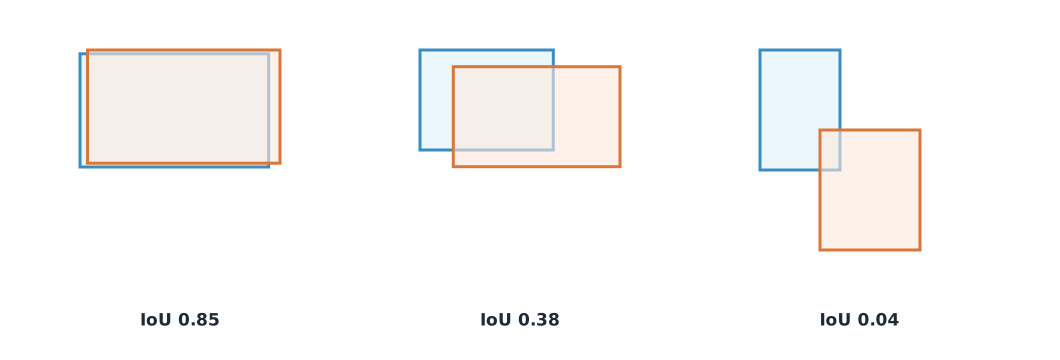
ผู้ติด label สองคนจำแนกภาพย่อย 100 ภาพเป็น รอยร้าว ไม่มี หรือคราบ และวาดกรอบรอยร้าวสามรายการเดียวกัน (ข้อมูลจำลอง) Cohen’s kappa (Cohen, 1960) ปรับความตรงกันที่เกิดจากความบังเอิญออก
a = ["crack"] * 40 + ["none"] * 50 + ["stain"] * 10
b = ["crack"] * 34 + ["none"] * 6 + ["none"] * 44 + ["crack"] * 4 + ["stain"] * 2 + ["stain"] * 8 + ["none"] * 2
n = len(a)
labels = sorted(set(a) | set(b))
po = sum(x == y for x, y in zip(a, b)) / n
pe = sum((a.count(c) / n) * (b.count(c) / n) for c in labels)
print(f"observed agreement {po:.2f}, chance agreement {pe:.2f}, kappa {(po - pe) / (1 - pe):.2f}")

def iou(p, q):                                  # กรอบ (x1, y1, x2, y2) หน่วยพิกเซล
    ix = max(0, min(p[2], q[2]) - max(p[0], q[0]))
    iy = max(0, min(p[3], q[3]) - max(p[1], q[1]))
    inter = ix * iy
    union = (p[2] - p[0]) * (p[3] - p[1]) + (q[2] - q[0]) * (q[3] - q[1]) - inter
    return inter / union

pairs = [((100, 100, 200, 160), (104, 98, 206, 158)), ((50, 50, 90, 80), (60, 55, 110, 85)),
         ((300, 200, 340, 260), (330, 240, 380, 300))]
for k, (p, q) in enumerate(pairs, 1):
    print(f"box {k}: IoU between annotators {iou(p, q):.2f}")
observed agreement 0.86, chance agreement 0.42, kappa 0.76
box 1: IoU between annotators 0.85
box 2: IoU between annotators 0.38
box 3: IoU between annotators 0.04ความตรงกัน 86% ดูสูง แต่เมื่อหักส่วนที่ตรงกันโดยบังเอิญแล้ว kappa เหลือราว 0.76 (kappa เท่ากับ 1 คือตรงกันทุกภาพ และเท่ากับ 0 คือตรงกันไม่ต่างจากความบังเอิญ) ส่วนกรอบรายการที่ 2 และ 3 มี IoU ต่ำ แปลว่าผู้ติด label เข้าใจขอบเขตของรอยร้าวต่างกัน ต้องทบทวนคู่มือเรื่องการวาดกรอบก่อนติด label ภาพที่เหลือ
แบ่งตามเที่ยวบินโดยรักษาสัดส่วนคลาส
ภาพจากเที่ยวบินเดียวกันคล้ายกันมาก ต้องอยู่ชุดเดียวกันทั้งเที่ยว (group split) แต่ถ้าแบ่งตามเที่ยวบินอย่างเดียว บางชุดอาจได้รอยร้าวน้อยหรือมากผิดปกติ scikit-learn มี StratifiedGroupKFold ที่รักษาทั้งกลุ่มและสัดส่วนคลาส ตัวอย่างนี้เขียนหลักการง่าย ๆ เองเพื่อให้เห็นกลไก
ตัวอย่างที่ 2 แบ่ง 12 เที่ยวบินเป็นชุดฝึก ตรวจสอบ และทดสอบ
แต่ละเที่ยวบินมีจำนวนภาพและสัดส่วนภาพที่มีรอยร้าวต่างกัน (ข้อมูลจำลอง) เรียงเที่ยวบินตามสัดส่วนรอยร้าว แล้วแจกเข้าชุดตามรูปแบบวนซ้ำ ฝึก ฝึก ตรวจสอบ ฝึก ฝึก ทดสอบ
flights = {"F01": (118, 0.138), "F02": (135, 0.245), "F03": (137, 0.160), "F04": (66, 0.107),
           "F05": (110, 0.060), "F06": (124, 0.220), "F07": (77, 0.228), "F08": (103, 0.130),
           "F09": (131, 0.201), "F10": (94, 0.246), "F11": (134, 0.243), "F12": (89, 0.234)}   # ภาพ, สัดส่วนรอยร้าว
pattern = ["train", "train", "val", "train", "train", "test"]
split = {"train": [], "val": [], "test": []}
for i, f in enumerate(sorted(flights, key=lambda k: flights[k][1])):
    split[pattern[i % len(pattern)]].append(f)

total = sum(n for n, _ in flights.values())
for name, fs in split.items():
    imgs = sum(flights[f][0] for f in fs)
    cracks = sum(flights[f][0] * flights[f][1] for f in fs)
    print(f"{name:<5} flights {', '.join(fs):<32} images {imgs:>4} ({imgs / total:.0%}), crack rate {cracks / imgs:.3f}")
assert not (set(split["train"]) & set(split["test"]))
train flights F05, F04, F01, F03, F06, F07, F11, F02 images 901 (68%), crack rate 0.180
val flights F08, F12 images 192 (15%), crack rate 0.178
test flights F09, F10 images 225 (17%), crack rate 0.220ชุดฝึกกับชุดตรวจสอบได้สัดส่วนรอยร้าวใกล้กันมาก ชุดทดสอบสูงกว่าเล็กน้อย และไม่มีเที่ยวบินใดอยู่ทั้งชุดฝึกและชุดทดสอบ เมื่อมีเที่ยวบินน้อย การแบ่งทำได้หยาบ ทั้งสัดส่วนภาพและสัดส่วนคลาสจึงไม่ตรงเป้าพอดี ในงานจริงควรเก็บข้อมูลจากหลายเที่ยวบินและหลายสถานที่ และระบุในเอกสารชุดข้อมูลว่าแบ่งอย่างไร
ตรวจชุดข้อมูลก่อนฝึก
หน่วยความรู้เรื่องตรวจชุดข้อมูลก่อนเทรน AI ของคลังความรู้โดรนฝึกหาข้อมูลรั่วจากเที่ยวบินเดียวกัน ภาพซ้ำ และข้อมูลไม่ครบด้วย CSV และ Python รายการตรวจขั้นต่ำคือ ภาพซ้ำหรือเกือบซ้ำข้ามชุด กรอบที่อยู่นอกภาพหรือมีขนาดศูนย์ ภาพที่ไม่มี label แต่ควรมี สัดส่วนคลาสของแต่ละชุด และสิทธิ์การใช้ภาพ
ปฏิบัติการประจำโมดูล
ปฏิบัติการ: ชุดข้อมูลที่เชื่อถือได้
- เขียนคู่มือการติด label หนึ่งหน้าสำหรับรอยร้าว พร้อมภาพตัวอย่างที่ใช่และไม่ใช่
- ให้เพื่อนสองคนติด label ภาพชุดเดียวกัน 50 ภาพใน CVAT คำนวณ kappa และ IoU ด้วยตัวอย่างที่ 1
- แก้คู่มือตรงที่ไม่ตรงกัน แล้วติด label ใหม่ วัดซ้ำ
- แบ่งชุดข้อมูลตามเที่ยวบินด้วยตัวอย่างที่ 2 หรือ
StratifiedGroupKFoldแล้วรายงานสัดส่วนคลาส - ตรวจชุดข้อมูลตามรายการขั้นต่ำ และเขียนเอกสารชุดข้อมูล
ข้อผิดพลาดที่พบบ่อย
ระวัง
- ติด label โดยไม่มีคู่มือ แล้วหวังว่าโมเดลจะเรียนเอง
- รายงานความตรงกันดิบ โดยไม่หักความบังเอิญ
- แบ่งแบบสุ่มระดับภาพ ทั้งที่ภาพจากเที่ยวบินเดียวกันคล้ายกัน
- แบ่งตามเที่ยวบินโดยไม่ดูสัดส่วนคลาส
- ไม่บันทึกสิทธิ์การใช้ภาพ
สรุป
- คู่มือการติด label ที่ชัดทำให้ label สอดคล้อง ซึ่งเป็นเพดานของความแม่นของโมเดล
- Cohen’s kappa หักความตรงกันโดยบังเอิญ IoU วัดความตรงกันของกรอบ
- แบ่งตามเที่ยวบินหรือสถานที่ และรักษาสัดส่วนคลาสให้ใกล้กันในทุกชุด
- ตรวจชุดข้อมูลก่อนฝึกทุกครั้งและบันทึกไว้ในเอกสารชุดข้อมูล
แบบฝึกตรวจความเข้าใจ
- = 0.9 และ = 0.5 ค่า kappa เท่าใด
- กรอบ (0,0,10,10) กับ (5,0,15,10) มี IoU เท่าใด
- ทำไมความตรงกัน 90% อาจยังไม่ดีพอ
- ทำไมต้องแบ่งตามเที่ยวบิน
- kappa เท่ากับ 0 หมายความว่าอะไร
เฉลย
- ทับกัน 50 พื้นที่รวม 150 ได้
- ถ้าคลาสหนึ่งพบมาก ความตรงกันสูงอาจเกิดจากความบังเอิญ ต้องดู kappa
- ภาพจากเที่ยวบินเดียวกันคล้ายกันมาก ถ้าแยกไปอยู่ทั้งชุดฝึกและชุดทดสอบ คะแนนจะดีเกินจริง
- ผู้ติด label ตรงกันไม่ต่างจากความบังเอิญ
สรุปสูตรสำคัญ
| Cohen's kappa | |
| IoU ของสองกรอบ |
แหล่งอ้างอิงหลัก
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. link
- scikit-learn developers. Cross-validation: Evaluating estimator performance (scikit-learn 1.9). link
- Géron, A. (2022). Hands-on machine learning with Scikit-Learn, Keras, and TensorFlow (3rd ed.). O'Reilly.
อ่านเพิ่มเติม
ศึกษาหน่วยความรู้ที่กำหนดล่วงหน้า ดูสื่อประกอบ และทำ quiz ประจำโมดูล
ในชั้นเรียน / ภาคสนาม
ปฏิบัติการในห้องแล็บหรือภาคสนามตามใบงาน พร้อม checklist ความปลอดภัย
หลักฐานการเรียนรู้: ใบงานที่ผ่านการตรวจและผล quiz