Deep learning และ object detection
UAT 306 ปัญญาประดิษฐ์สำหรับระบบอากาศยานไร้คนขับ
บทเรียน
เมื่อเรียนจบโมดูลนี้ ผู้เรียนจะสามารถ
- คำนวณขนาดเอาต์พุตและจำนวนพารามิเตอร์ของชั้นคอนโวลูชัน
- อธิบายว่าตัวตรวจจับวัตถุทำนายทั้งคลาสและตำแหน่ง
- เขียน non-maximum suppression เพื่อตัดกรอบซ้ำ
- คำนวณ precision recall และ average precision ของตัวตรวจจับ
ทำไมต้องรู้
หน่วยความรู้เรื่องการเรียนรู้เชิงลึกและ CNN ของคลังความรู้โดรนครอบคลุมโครงข่ายประสาทเทียม CNN transfer learning และ object detection ส่วนหน่วยความรู้เรื่องฝึกและประเมิน object detection อธิบายว่าตัวตรวจจับต้องทำนายทั้งชนิดและตำแหน่งวัตถุ IoU ใช้จับคู่คำทำนายกับคำตอบ และ mAP รวมการจัดอันดับกับหลายเงื่อนไข โมดูลนี้คำนวณส่วนสำคัญเหล่านี้เองทีละขั้น เพื่อให้อ่านผลของเครื่องมืออย่าง Ultralytics YOLO ได้อย่างเข้าใจ
ชั้นคอนโวลูชัน
ชั้น คอนโวลูชัน เลื่อนตัวกรองขนาด ไปบนภาพ ผลคูณสะสมกลายเป็นแผนที่ลักษณะเด่น ขนาดเอาต์พุตขึ้นกับขนาดอินพุต ขนาดตัวกรอง การเติมขอบ และระยะก้าว ตามสูตรใน A guide to convolution arithmetic (Dumoulin และ Visin, 2016) ตัวกรองหนึ่งตัวมีน้ำหนัก บวก bias หนึ่งค่า และชั้นหนึ่งมีตัวกรอง ตัว
ตัวอย่างที่ 1 ขนาดและพารามิเตอร์ของชั้นแรก ๆ
def conv_out(i, k, s, p):
    return (i + 2 * p - k) // s + 1

def conv_params(k, c_in, c_out):
    return k * k * c_in * c_out + c_out

print("640 px, k=3, s=1, p=1 ->", conv_out(640, 3, 1, 1))
print("640 px, k=3, s=2, p=1 ->", conv_out(640, 3, 2, 1))
print("layer 3x3, RGB -> 32 channels:", conv_params(3, 3, 32), "parameters")
print("layer 3x3, 32 -> 64 channels:", conv_params(3, 32, 64), "parameters")
full = 640 * 640 * 3 * 32
print(f"a fully connected layer from a 640x640 RGB image to 32 outputs would need {full:,} weights")
640 px, k=3, s=1, p=1 -> 640
640 px, k=3, s=2, p=1 -> 320
layer 3x3, RGB -> 32 channels: 896 parameters
layer 3x3, 32 -> 64 channels: 18496 parameters
a fully connected layer from a 640x640 RGB image to 32 outputs would need 39,321,600 weightsชั้นคอนโวลูชันมีพารามิเตอร์น้อยมากเมื่อเทียบกับชั้นเชื่อมต่อเต็ม เพราะใช้ตัวกรองชุดเดียวกันทั่วภาพ ระยะก้าว 2 ลดขนาดภาพลงครึ่งหนึ่ง โครงข่ายตรวจจับจึงลดขนาดแผนที่ลักษณะเด่นทีละขั้นเพื่อเห็นบริบทกว้างขึ้น
ตัดกรอบซ้ำด้วย NMS
ตัวตรวจจับมักทำนายหลายกรอบรอบวัตถุเดียวกัน non-maximum suppression (NMS) แบบละโมบเก็บกรอบที่คะแนนสูงสุด แล้วตัดกรอบอื่นที่ทับมันเกินค่า IoU ที่กำหนด ทำซ้ำจนหมด วิธีนี้ใช้ใน R-CNN (Girshick และคณะ, 2014) และมีในไลบรารีอย่าง torchvision.ops.nms
Precision recall และ AP
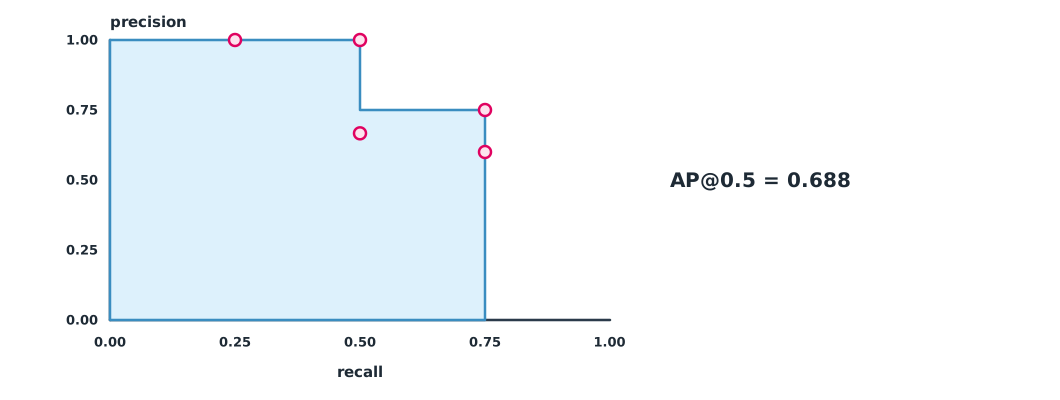
เมื่อจับคู่คำทำนายกับคำตอบ คำทำนายที่ IoU กับคำตอบเกิน 0.5 นับเป็นถูก (true positive) ตามเกณฑ์ของ PASCAL VOC (Everingham และคณะ, 2010) โดยจับคู่เรียงตามคะแนนจากสูงไปต่ำ คำตอบหนึ่งจับคู่ได้ครั้งเดียว คำทำนายซ้ำนับเป็นผิด จากนั้นคำนวณ precision และ recall สะสม average precision (AP) สรุปเส้น precision–recall เป็นตัวเลขเดียว บทความ VOC ใช้ค่าเฉลี่ยของ precision ที่ recall 11 ระดับ ส่วน COCO ใช้ 101 ระดับ และเฉลี่ยที่ IoU 0.50 ถึง 0.95 (Lin และคณะ, 2014) จึงเข้มกว่า ตัวอย่างนี้คำนวณพื้นที่ใต้เส้นทุกจุดหลังทำให้ precision ไม่ลดลงเมื่อ recall ลดลง
ตัวอย่างที่ 2 NMS แล้วคำนวณ AP ที่ IoU 0.5
ภาพหนึ่งมีรอยร้าว 4 จุด ตัวตรวจจับทำนาย 7 กรอบ (ข้อมูลจำลอง)
import numpy as np

def iou(p, q):
    ix = max(0, min(p[2], q[2]) - max(p[0], q[0]))
    iy = max(0, min(p[3], q[3]) - max(p[1], q[1]))
    inter = ix * iy
    return inter / ((p[2] - p[0]) * (p[3] - p[1]) + (q[2] - q[0]) * (q[3] - q[1]) - inter)

dets = [(0.95, (100, 100, 200, 160)), (0.90, (105, 102, 203, 165)), (0.85, (300, 200, 340, 260)),
        (0.80, (500, 50, 560, 110)), (0.60, (302, 198, 345, 262)), (0.55, (700, 300, 760, 350)),
        (0.40, (900, 400, 950, 460))]
gts = [(102, 101, 201, 162), (301, 201, 342, 259), (700, 305, 758, 352), (80, 500, 140, 560)]

kept = []
for score, box in sorted(dets, reverse=True):          # NMS แบบละโมบ
    if all(iou(box, k) < 0.5 for _, k in kept):
        kept.append((score, box))
print("after NMS:", [s for s, _ in kept])

used, tp = set(), []
for score, box in kept:
    g = max(range(len(gts)), key=lambda j: iou(box, gts[j]))
    hit = iou(box, gts[g]) > 0.5 and g not in used
    used.add(g) if hit else None
    tp.append(hit)
ctp = np.cumsum(tp)
prec = ctp / np.arange(1, len(tp) + 1)
rec = ctp / len(gts)
for s, p, r in zip([s for s, _ in kept], prec, rec):
    print(f"score {s:.2f}: precision {p:.2f}, recall {r:.2f}")
p_interp = np.maximum.accumulate(prec[::-1])[::-1]
ap = np.sum(np.diff(np.r_[0, rec]) * p_interp)
print(f"AP@0.5 = {ap:.3f}")
after NMS: [0.95, 0.85, 0.8, 0.55, 0.4]
score 0.95: precision 1.00, recall 0.25
score 0.85: precision 1.00, recall 0.50
score 0.80: precision 0.67, recall 0.50
score 0.55: precision 0.75, recall 0.75
score 0.40: precision 0.60, recall 0.75
AP@0.5 = 0.688NMS ตัดกรอบซ้ำสองกรอบที่ทับกรอบที่คะแนนสูงกว่า จากนั้นมีคำทำนายถูก 3 จาก 5 และพบรอยร้าว 3 จาก 4 จุด AP ต่ำกว่า 1 เพราะมีคำทำนายผิดคะแนนสูงแทรกอยู่ และมีรอยร้าวที่ไม่ถูกตรวจพบเลย ค่า AP ของเครื่องมือจริงคำนวณจากทุกภาพในชุดทดสอบรวมกัน และแต่ละเครื่องมืออาจใช้วิธีประมาณพื้นที่ต่างกันเล็กน้อย ต้องระบุว่าใช้เกณฑ์ใดเมื่อรายงาน
ปฏิบัติการประจำโมดูล
ปฏิบัติการ: ฝึกและประเมินตัวตรวจจับ
- คำนวณขนาดแผนที่ลักษณะเด่นของสามชั้นแรกของโมเดลที่จะใช้ ด้วยตัวอย่างที่ 1
- ฝึกตัวตรวจจับ (เช่น YOLO ขนาดเล็ก) ด้วยชุดข้อมูลจากโมดูล 3 แบบ transfer learning
- ส่งออกคำทำนายบนชุดตรวจสอบ คำนวณ AP@0.5 ด้วยตัวอย่างที่ 2 เทียบกับค่าที่เครื่องมือรายงาน
- เปลี่ยนค่า IoU ของ NMS และค่าขีดแบ่งความมั่นใจ สังเกต precision และ recall
- ดูภาพที่ทำนายผิดทีละภาพ จัดกลุ่มสาเหตุ
ข้อผิดพลาดที่พบบ่อย
ระวัง
- เทียบ AP ที่คนละเกณฑ์ เช่น AP@0.5 กับ AP@0.5:0.95
- ลืม NMS แล้วนับกรอบซ้ำเป็นการตรวจจับ
- ดูแค่ค่า mAP โดยไม่ดูภาพที่ผิด
- ฝึกจากศูนย์ทั้งที่ข้อมูลน้อย แทน transfer learning
- ใช้ภาพขนาดเล็กเกินไป จนรอยร้าวเล็กหายไปหลังลดขนาด
สรุป
- ขนาดเอาต์พุตของคอนโวลูชันคือ และจำนวนพารามิเตอร์ไม่ขึ้นกับขนาดภาพ
- NMS เก็บกรอบคะแนนสูงสุดแล้วตัดกรอบที่ทับเกินค่า IoU ที่กำหนด
- คำทำนายถูกเมื่อ IoU เกิน 0.5 กับคำตอบที่ยังไม่ถูกจับคู่ (เกณฑ์ VOC) AP คือพื้นที่ใต้เส้น precision–recall
- รายงาน AP พร้อมเกณฑ์ IoU และวิธีคำนวณเสมอ
แบบฝึกตรวจความเข้าใจ
- อินพุต 320 ตัวกรอง 3 ระยะก้าว 2 เติมขอบ 1 เอาต์พุตขนาดเท่าใด
- ชั้น 3×3 จาก 64 ไป 128 ช่องมีพารามิเตอร์เท่าใด
- สองกรอบ IoU 0.7 NMS ที่ค่า 0.5 เก็บกี่กรอบ
- คำทำนายสองกรอบ IoU เกิน 0.5 กับคำตอบเดียวกัน นับอย่างไร
- ทำไม AP ของ COCO จึงมักต่ำกว่า AP@0.5
เฉลย
- หนึ่งกรอบ (กรอบที่คะแนนสูงกว่า)
- กรอบแรกเป็นถูก กรอบที่สองเป็นผิด
- เฉลี่ยจาก IoU 0.50 ถึง 0.95 ซึ่งเกณฑ์สูงต้องวางกรอบแม่นกว่ามาก
สรุปสูตรสำคัญ
| ขนาดเอาต์พุตของคอนโวลูชัน | |
| จำนวนพารามิเตอร์ของชั้นคอนโวลูชัน | |
| average precision |
แหล่งอ้างอิงหลัก
- Prince, S. J. D. (2023). Understanding deep learning. MIT Press. link
- Géron, A. (2022). Hands-on machine learning with Scikit-Learn, Keras, and TensorFlow (3rd ed.). O'Reilly.
- Dumoulin, V., & Visin, F. (2016). A guide to convolution arithmetic for deep learning (arXiv:1603.07285). link
- Girshick, R., Donahue, J., Darrell, T., & Malik, J. (2014). Rich feature hierarchies for accurate object detection and semantic segmentation. In 2014 IEEE Conference on Computer Vision and Pattern Recognition (pp. 580–587). link
- PyTorch Contributors. torchvision.ops.nms. Torchvision documentation. link
- Everingham, M., Van Gool, L., Williams, C. K. I., Winn, J., & Zisserman, A. (2010). The PASCAL visual object classes (VOC) challenge. International Journal of Computer Vision, 88(2), 303–338. link
- Lin, T.-Y., Maire, M., Belongie, S., Hays, J., Perona, P., Ramanan, D., Dollár, P., & Zitnick, C. L. (2014). Microsoft COCO: Common objects in context. In Computer Vision – ECCV 2014 (pp. 740–755). Springer. link
อ่านเพิ่มเติม
ศึกษาหน่วยความรู้ที่กำหนดล่วงหน้า ดูสื่อประกอบ และทำ quiz ประจำโมดูล
การเรียนรู้เชิงลึกและ CNN
ฝึกและประเมิน object detection
Ultralytics YOLO
ในชั้นเรียน / ภาคสนาม
ปฏิบัติการในห้องแล็บหรือภาคสนามตามใบงาน พร้อม checklist ความปลอดภัย
หลักฐานการเรียนรู้: ใบงานที่ผ่านการตรวจและผล quiz