Edge AI บนโดรน
UAT 322 ปฏิบัติการปัญญาประดิษฐ์และการประกอบรวมระบบอากาศยานไร้คนขับอัตโนมัติ
บทเรียน
เมื่อเรียนจบโมดูลนี้ ผู้เรียนจะสามารถ
- อธิบายขั้นตอนนำโมเดล AI ขึ้นอุปกรณ์ปลายทาง ตั้งแต่ส่งออก ONNX จนถึงปรับให้เหมาะกับฮาร์ดแวร์
- คำนวณการแปลงค่าแบบ INT8 quantization และขอบเขตความคลาดเคลื่อน
- วัดเวลาหน่วงตั้งแต่รับภาพถึงได้ผลด้วย p95 และเทียบกับงบเวลาต่อเฟรม
- เขียน model card ที่ระบุเงื่อนไขทดสอบ ข้อจำกัด และเกณฑ์หยุดใช้
ทำไมต้องรู้
โมเดลตรวจจับวัตถุที่ได้ความแม่นยำสูงบนคอมพิวเตอร์ตั้งโต๊ะ อาจช้าเกินไปเมื่อย้ายขึ้นบอร์ดบนโดรนที่มีกำลังไฟไม่กี่สิบวัตต์ ถ้าตรวจพบคนหรือสิ่งกีดขวางช้าไปครึ่งวินาที โดรนที่บิน 8 m/s ก็เคลื่อนไปแล้ว 4 m การนำ AI ขึ้นอุปกรณ์ปลายทาง (edge AI) จึงเป็นการแลกกันระหว่างความเร็ว ความแม่นยำ หน่วยความจำ และพลังงาน ซึ่งต้องวัดจริง ไม่ใช่อ่านจากโฆษณา
จากโมเดลสู่บอร์ด
- ฝึกและประเมิน บนเครื่องที่มีกำลังสูง (UAT 315)
- ส่งออก เป็นรูปแบบกลาง เช่น ONNX แล้วตรวจว่าผลลัพธ์ตรงกับโมเดลเดิม
- ปรับให้เหมาะ กับฮาร์ดแวร์ เช่น ใช้ ONNX Runtime บน CPU หรือ TensorRT บน GPU ของ NVIDIA และลดความละเอียดตัวเลขด้วย quantization
- วัดบนบอร์ดจริง ทั้งความเร็ว ความแม่นยำ หน่วยความจำ อุณหภูมิ และกำลังไฟ
บอร์ดยอดนิยม เช่น Jetson Orin Nano Super ซึ่ง NVIDIA ระบุประสิทธิภาพไว้ที่ 67 TOPS เป็นตัวเลข INT8 แบบ sparse ไม่ได้บอกความเร็วของโมเดลของเรา ตัวเลขที่ใช้ตัดสินใจต้องมาจากการวัดโมเดลจริงบนบอร์ดจริง
Quantization
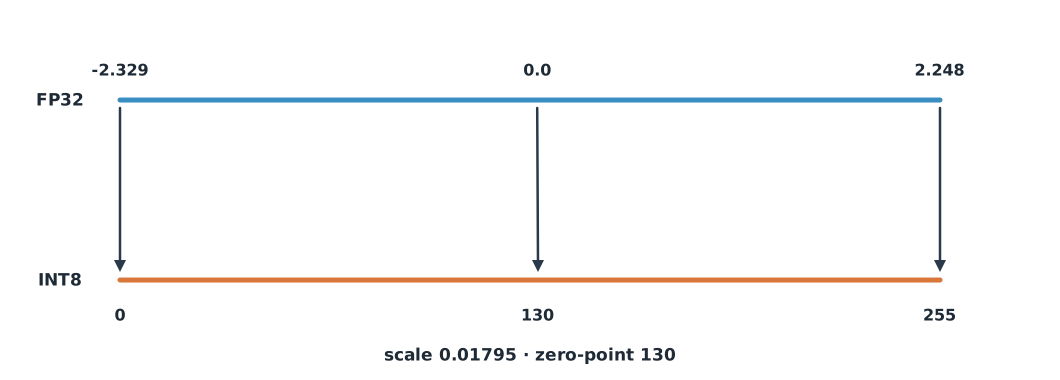
Quantization เก็บน้ำหนักและค่าในโมเดลด้วยจำนวนเต็ม 8 บิตแทนทศนิยม 32 บิต ประหยัดหน่วยความจำ 4 เท่าและคำนวณได้เร็วขึ้นบนฮาร์ดแวร์ที่รองรับ ONNX Runtime ใช้การแปลงเชิงเส้น เมื่อ คือ scale และ คือ zero-point (ค่าจำนวนเต็มที่แทน 0.0) งานของ Jacob และคณะ (2018) วางหลักการคำนวณด้วยจำนวนเต็มล้วนที่ใช้กันทั่วไป
ตัวอย่างที่ 1 แปลงน้ำหนัก FP32 เป็น INT8
import numpy as np

rng = np.random.default_rng(348)
w = rng.normal(0, 0.8, 1000).astype(np.float32)        # น้ำหนักสมมติ 1000 ค่า
lo, hi = float(w.min()), float(w.max())
scale = (hi - lo) / 255
zero_point = int(round(-lo / scale))
q = np.clip(np.round(w / scale) + zero_point, 0, 255).astype(np.uint8)
restored = scale * (q.astype(np.float32) - zero_point)
err = np.abs(restored - w)
print(f"range [{lo:.3f}, {hi:.3f}], scale {scale:.5f}, zero-point {zero_point}")
print(f"max error {err.max():.5f} (half a step = {scale / 2:.5f}); memory {w.nbytes} -> {q.nbytes} bytes")
range [-2.329, 2.248], scale 0.01795, zero-point 130
max error 0.00896 (half a step = 0.00897); memory 4000 -> 1000 bytesความคลาดเคลื่อนสูงสุดไม่เกินครึ่งขั้นของ scale และหน่วยความจำลดลง 4 เท่า แต่ความคลาดเคลื่อนเล็ก ๆ นับพันค่ารวมกันอาจทำให้ผลตรวจจับเปลี่ยน จึงต้อง ประเมินความแม่นยำใหม่ทุกครั้งหลัง quantize ONNX Runtime มีสองแบบ คือ static ที่ใช้ข้อมูลตัวอย่างหาค่า scale ล่วงหน้า (แนะนำสำหรับ CNN) และ dynamic ที่คำนวณ scale ของค่ากลางระหว่างรัน
วัดเวลาหน่วงให้ถูก
เวลาที่โมเดลใช้คำนวณ (inference) ไม่เท่ากับเวลาตั้งแต่ได้ภาพจนได้ผล (end-to-end) ซึ่งรวมการเตรียมภาพ และการประมวลผลหลัง เช่น กรองกรอบที่ซ้อนกัน ต้องวัดหลัง warm-up และรายงาน p95 คือค่าที่ 95% ของตัวอย่างไม่เกิน เพราะค่าเฉลี่ยซ่อนเฟรมที่ช้าผิดปกติไว้
ตัวอย่างที่ 2 เทียบ FP32 กับ INT8 ที่งบ 30 fps
ต่อจากตัวอย่างที่ 1 (ใช้ตัวสร้างเลขสุ่มตัวเดิม) จำลองเวลา 400 เฟรมของแต่ละขั้น หน่วยเป็นมิลลิวินาที
def p95(x):
    s = np.sort(x)
    return s[int(np.ceil(0.95 * len(s))) - 1]            # nearest-rank


n = 400
pre = rng.normal(4.0, 0.5, n)
fp32 = rng.gamma(9, 4.6, n)
int8 = rng.gamma(9, 2.0, n)
post = rng.normal(3.0, 0.4, n)
budget = 1000 / 30
for name, inference in (("FP32", fp32), ("INT8", int8)):
    e2e = pre + inference + post
    print(f"{name}: inference median {np.median(inference):.1f} ms | end-to-end mean {e2e.mean():.1f}, "
          f"p95 {p95(e2e):.1f} ms | over {budget:.1f} ms: {(e2e > budget).mean():.0%} | "
          f"distance at 8 m/s during p95: {8 * p95(e2e) / 1000:.2f} m")
FP32: inference median 40.8 ms | end-to-end mean 49.8, p95 73.5 ms | over 33.3 ms: 90% | distance at 8 m/s during p95: 0.59 m
INT8: inference median 17.7 ms | end-to-end mean 25.3, p95 36.1 ms | over 33.3 ms: 10% | distance at 8 m/s during p95: 0.29 mINT8 เร็วกว่ามาก แต่ p95 ยังเกินงบ 33.3 ms อยู่เล็กน้อย ราว 10% ของเฟรมจะช้ากว่างบ ทางเลือกคือลดขนาดภาพ ลดอัตราเฟรมที่ประมวลผล หรือยอมรับแล้วเพิ่มระยะปลอดภัย การตัดสินใจต้องดูความแม่นยำหลัง quantize ประกอบเสมอ
Model card
Mitchell และคณะ (2019) เสนอ model card เอกสารสั้นที่มากับโมเดลทุกรุ่น สำหรับโดรนควรมีอย่างน้อย
- รุ่นและที่มา รุ่นโมเดล ชุดข้อมูลที่ใช้ฝึก และรุ่นซอฟต์แวร์
- เงื่อนไขทดสอบ บอร์ด ขนาดภาพ runtime ความละเอียดตัวเลข จำนวนรอบ warm-up และจำนวนตัวอย่าง
- ผลลัพธ์ ความแม่นยำแยกตามสภาพ (กลางวัน เย็น หมอก) และเวลาหน่วง p95
- ข้อจำกัดและการใช้ที่ไม่ควรทำ เช่น ไม่ได้ทดสอบเวลากลางคืน
- เกณฑ์หยุดใช้และถอยกลับ เช่น ถ้าความแม่นยำภาคสนามต่ำกว่าเกณฑ์ ให้กลับไปใช้รุ่นก่อน
ปฏิบัติการประจำโมดูล
ปฏิบัติการ: วัดโมเดลตรวจจับบนบอร์ดจริง
- ส่งออกโมเดลตรวจจับจาก UAT 315 เป็น ONNX และตรวจว่าผลลัพธ์ตรงกับโมเดลเดิมบนภาพชุดเดียวกัน
- ทำ static quantization ด้วย ONNX Runtime โดยใช้ภาพจากงานจริงเป็นข้อมูลปรับเทียบ แล้วประเมินความแม่นยำก่อนและหลัง
- บนบอร์ดคอมพิวเตอร์บนลำ วัดเวลา model-only และ end-to-end หลัง warm-up อย่างน้อย 10 รอบ วัด 400 รอบ เก็บเป็น CSV
- คำนวณ p95 ด้วยโค้ดในตัวอย่างที่ 2 เทียบงบเวลาต่อเฟรม และบันทึกอุณหภูมิกับกำลังไฟของบอร์ดขณะทดสอบ
- เขียน model card หนึ่งหน้าพร้อมเกณฑ์หยุดใช้
ข้อผิดพลาดที่พบบ่อย
ระวัง
- ใช้ตัวเลข TOPS ของผู้ผลิตแทนการวัดจริง
- วัดเฉพาะเวลา inference แล้วเรียกว่าเวลาหน่วงของระบบ
- วัดโดยไม่ warm-up หรือรายงานเฉพาะค่าเฉลี่ย
- quantize แล้วไม่ประเมินความแม่นยำใหม่
- วัดบน PC แล้วสรุปแทนบอร์ดบนโดรน
สรุป
- ขั้นตอนคือฝึก ส่งออก ONNX ปรับให้เหมาะกับฮาร์ดแวร์ แล้ววัดบนบอร์ดจริง
- INT8 quantization ใช้ ลดหน่วยความจำ 4 เท่า แต่ต้องประเมินความแม่นยำใหม่
- เวลาหน่วงต้องวัดแบบ end-to-end หลัง warm-up และรายงาน p95 เทียบงบเวลาต่อเฟรม
- Model card บอกเงื่อนไขทดสอบ ผล ข้อจำกัด และเกณฑ์หยุดใช้
แบบฝึกตรวจความเข้าใจ
- ค่าน้ำหนักอยู่ในช่วง −1.0 ถึง 1.55 scale สำหรับ INT8 เท่าใด
- ถ้า scale = 0.02 และ zero-point = 50 ค่า แทนค่าจริงเท่าใด
- ที่ 25 fps งบเวลาต่อเฟรมเท่าใด
- เวลา 20 ค่า คือ 1 ถึง 20 ms p95 แบบ nearest-rank เท่าใด
- ทำไมต้องประเมินความแม่นยำใหม่หลัง quantize
เฉลย
- ms
- ลำดับที่ คือ 19 ms
- ความคลาดเคลื่อนเล็ก ๆ จากการปัดเศษรวมกันอาจเปลี่ยนผลตรวจจับ
สรุปสูตรสำคัญ
| Quantization แบบเชิงเส้น | |
| p95 แบบ nearest-rank | |
| งบเวลาต่อเฟรม |
แหล่งอ้างอิงหลัก
- Microsoft. Quantize ONNX models. ONNX Runtime documentation. link
- ONNX Runtime. Documentation. link
- NVIDIA. NVIDIA TensorRT documentation. link
- Jacob, B., Kligys, S., Chen, B., Zhu, M., Tang, M., Howard, A., Adam, H., & Kalenichenko, D. (2018). Quantization and training of neural networks for efficient integer-arithmetic-only inference. In 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 2704–2713). link
- NVIDIA. (2024). NVIDIA Jetson Orin Nano developer kit gets a "super" boost. NVIDIA Technical Blog. link
- Warden, P., & Situnayake, D. (2020). TinyML: Machine learning with TensorFlow Lite on Arduino and ultra-low-power microcontrollers. O'Reilly Media.
- Mitchell, M., Wu, S., Zaldivar, A., Barnes, P., Vasserman, L., Hutchinson, B., Spitzer, E., Raji, I. D., & Gebru, T. (2019). Model cards for model reporting. In Proceedings of the Conference on Fairness, Accountability, and Transparency (pp. 220–229). ACM. link
อ่านเพิ่มเติม
ศึกษาหน่วยความรู้ที่กำหนดล่วงหน้า ดูสื่อประกอบ และทำ quiz ประจำโมดูล
การนำโมเดล AI ขึ้นอุปกรณ์ปลายทาง
benchmark และแผนใช้งาน Edge
Computer Vision และการต่อยอดสู่ Edge AI
ในชั้นเรียน / ภาคสนาม
ปฏิบัติการเข้มข้นในแล็บและภาคสนาม บันทึกผลลงสมุดปฏิบัติการ
หลักฐานการเรียนรู้: สมุดปฏิบัติการที่อาจารย์ลงนาม